제외 목록에 없는 항목을 고르는 SQL이 갑자기 0행을 반환한다면 NULL의 영향을 확인할 만하다. SQLite에서 오른쪽 목록에 2만 넣었을 때는 1과 3이 남았지만, 같은 목록에 NULL을 한 행 추가하자 NOT IN의 결과가 모두 사라졌다. 이 차이를 작은 재현 실험으로 살펴봤다. SQLite 기반 조회에서 ‘일치하는 행이 없다’는 조건과 ‘목록에 포함되지 않는다’는 조건이 언제 달라지는지 확인하려는 실험으로, 속도가 아닌 반환 행의 의미를 비교했다.
비교하려는 것은 문법이 아니라 NULL의 처리 정책
먼저 원래의 NOT IN, 오른쪽에서 NULL을 제거한 NOT IN, 등호로 연결한 NOT EXISTS를 비교했다. 오른쪽 목록의 NULL만 지우면 문제가 해결되는지, NOT EXISTS로 바꿔도 원래 결과가 유지되는지 확인하기 위해서다. 이어서 왼쪽 NULL을 제외하는 조건과 SQLite의 IS 비교를 추가했다. 이때는 NULL을 비교 대상에 포함할지에 따라 정책이 달라지므로 단순한 문법 교체로 보지 않았다.
SQLite 공식 표현식 문서는 IN과 NOT IN의 결과를 왼쪽과 오른쪽의 NULL 여부, 빈 집합 여부, 실제 일치 여부에 따라 설명한다. 오른쪽이 비어 있지 않고 NULL을 포함할 때 왼쪽 값과 일치하는 항목이 없으면 두 연산 모두 NULL을 반환한다.[1] WHERE는 참인 행만 통과시키고 거짓이나 NULL인 행은 제외한다.[2] 그래서 ‘제외 목록에서 못 찾았다’는 상황이 곧 조건이 참이라는 뜻은 아니다. 비교 결과를 알 수 없는 행도 출력에서 빠진다.
재현 조건과 방법
실험에는 Python 3.11.15의 sqlite3 모듈과 SQLite 3.50.4를 사용했다. 메모리 데이터베이스에 candidates(id INTEGER)와 blocked(id INTEGER)를 만들고, 왼쪽 테이블에 1, 2, 3, NULL을 한 행씩 넣었다. 오른쪽은 2만 있는 경우, 2와 NULL이 있는 경우, NULL만 있는 경우, 빈 경우로 바꿨다. 외부 서비스나 운영 데이터는 조회하지 않았다.
왼쪽 네 행은 그대로 두고 오른쪽 네 집합에 쿼리 다섯 종류를 각각 실행했다. 결과는 id로 정렬한 전체 행 배열로 받아 미리 적어 둔 기대값과 비교했다. 또 1과 NULL을 왼쪽 피연산자로 둔 NOT IN 식을 따로 계산하고, NULL을 허용하는 UNIQUE 열에 NULL 두 행을 넣어 봤다. 지연 시간과 실행 계획은 측정 대상에 포함하지 않았다.
CREATE TABLE candidates(id INTEGER);
INSERT INTO candidates VALUES (1), (2), (3), (NULL);
CREATE TABLE blocked(id INTEGER);
-- blocked에는 각 실험 조건의 행을 넣는다.

-- A: 원래 NOT IN
SELECT id FROM candidates
WHERE id NOT IN (SELECT id FROM blocked)
ORDER BY id;

-- B: 오른쪽 NULL만 제거
SELECT id FROM candidates
WHERE id NOT IN (
  SELECT id FROM blocked WHERE id IS NOT NULL
)
ORDER BY id;

-- C: 등호로 연결한 NOT EXISTS
SELECT c.id FROM candidates AS c
WHERE NOT EXISTS (
  SELECT 1 FROM blocked AS b WHERE b.id = c.id
)
ORDER BY c.id;
NULL을 오른쪽에 추가했을 때
오른쪽이 2 한 행일 때 원래 NOT IN과 오른쪽 NULL을 제거한 NOT IN은 모두 1과 3, 즉 2행을 반환했다. 등호로 연결한 NOT EXISTS는 여기에 왼쪽 NULL까지 포함해 3행을 반환했다. 오른쪽이 2와 NULL일 때 원래 NOT IN은 0행, 오른쪽 NULL을 제거한 NOT IN은 2행, 등호로 연결한 NOT EXISTS는 3행이었다. 오른쪽이 NULL 한 행일 때는 각각 0행, 4행, 4행이었고, 오른쪽이 비면 세 방식 모두 4행을 반환했다.
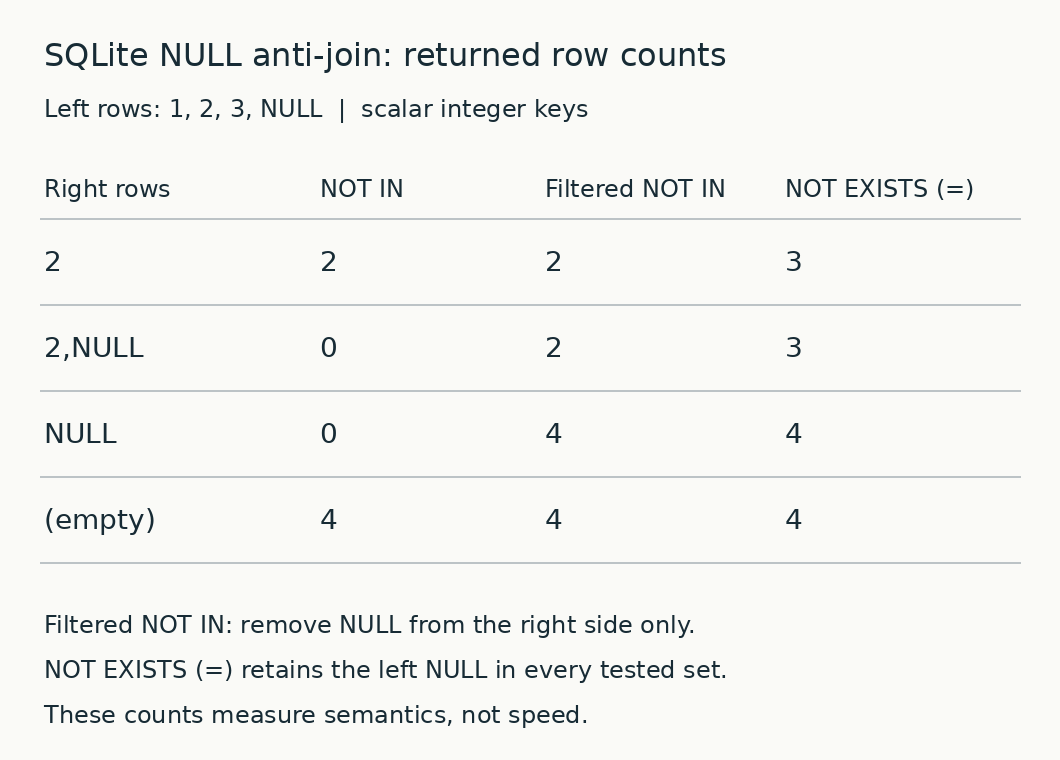
그림에는 이번 실행에서 얻은 반환 행 수를 담았다. ‘Filtered NOT IN’은 오른쪽에만 IS NOT NULL을 넣은 방식이고, ‘NOT EXISTS (=)’는 등호로 연결한 방식이다. 일부 조건에서 행 수가 같더라도 두 쿼리를 동등하다고 볼 수는 없다. 위쪽 두 행에서는 수가 달랐으며 실제 반환값에도 차이가 있었다. 오른쪽이 2와 NULL일 때 B는 1과 3을 반환했고 C는 NULL, 1, 3을 반환했다.
오른쪽의 NULL은 1이나 3과 같은지 다른지 판단할 근거가 되지 않는다. 이 조건에서 NOT IN의 결과는 NULL이므로 WHERE를 통과하지 못한다.[1][2] 이를 확인하려고 1 NOT IN (SELECT id FROM blocked)를 따로 계산했다. 오른쪽이 2일 때는 1이 나왔고, 2와 NULL일 때는 NULL이 나왔다. 같은 연결에서 오른쪽 내용만 바꿔도 결과가 달라졌으므로, 이 재현에서는 구문 오류나 연결 장애로 출력이 사라졌다고 볼 필요가 없었다.
오른쪽 NULL 제거로 해결되지 않는 반례
오른쪽 NULL을 제거하자 정수 값 1과 3은 다시 결과에 들어왔다. 하지만 이 수정으로 왼쪽 NULL을 어떻게 처리할지까지 정해지는 것은 아니다. 오른쪽이 2일 때 B는 왼쪽 NULL을 제외했고 C는 남겼다. 따라서 ‘오른쪽 NULL만 지우면 등호 기반 NOT EXISTS와 완전히 같은 결과가 된다’는 가정은 이번 실험에서 성립하지 않았다. 기대값 배열과 대조한 행 수도 각각 2와 3으로 달랐다.
EXISTS는 하위 쿼리가 행을 하나라도 반환하면 1, 반환하지 않으면 0이 된다. 선택한 열의 값이나 NULL 여부는 EXISTS의 결과를 바꾸지 않는다.[1] C의 동작을 이해하려면 하위 쿼리의 b.id = c.id를 봐야 한다. 이번 데이터에서 이 조건은 왼쪽 NULL과 일치하는 행을 찾지 못했다. 그 결과 NOT EXISTS가 참이 되어 왼쪽 NULL이 남았다. NOT EXISTS가 NULL을 자동으로 제외하는 것은 아니다.
빈 목록은 또 다른 경계 조건
빈 오른쪽 집합도 따로 확인해야 한다. SQLite의 NOT IN은 오른쪽이 비어 있으면 왼쪽이 NULL이어도 참을 반환한다.[1] 실제로 원래 NOT IN은 NULL, 1, 2, 3의 4행을 반환했다. 오른쪽에 NULL만 있던 조건에서 B로 NULL을 제거했을 때도 오른쪽이 빈 집합이 되어 같은 네 행이 나왔다. 왼쪽 NULL이 언제나 탈락한다고 가정하면 이 조건을 놓치게 된다.
이 차이를 테스트에 남기기 위해 ‘정상 값 몇 건이 살아났는가’에 더해 NULL이 포함됐는지도 확인했다. 기대값은 전체 행 배열로 적었다. 네 조건별 비교와 NOT IN의 NULL 반례, B와 C의 비동등성, 빈 집합의 스칼라 결과, UNIQUE 삽입 결과를 검사한 8개의 assert 문은 모두 통과했다. 이는 작은 입력에서 예상한 결과를 확인했다는 뜻이며 실제 서비스의 모든 입력을 검증한 결과는 아니다.
왼쪽 NULL을 어떻게 취급할 것인가
미정인 id는 결과에 넣지 않는 정책이라면 C의 바깥 조건에 c.id IS NOT NULL AND를 추가할 수 있다. 이 네 조건에서 그 방식은 순서대로 1과 3, 1과 3, 1·2·3, 1·2·3을 반환했다. 반대로 오른쪽의 NULL이 왼쪽 NULL을 제외하는 표시여야 한다면, 이번 SQLite 실험에서는 하위 쿼리의 등호를 IS로 바꾼 대안이 그 동작을 보였다. 오른쪽이 2와 NULL일 때 1과 3이 남았고, NULL만 있을 때 1·2·3이 남았다. 오른쪽이 2만 있거나 비었을 때는 왼쪽 NULL이 남았다. 어느 쪽도 원래 NOT IN을 무조건 보존하는 치환은 아니다.
-- 왼쪽의 미정 id는 결과에서 제외하는 정책
SELECT c.id FROM candidates AS c
WHERE c.id IS NOT NULL
  AND NOT EXISTS (
    SELECT 1 FROM blocked AS b WHERE b.id = c.id
  )
ORDER BY c.id;

-- 이번 SQLite에서 NULL과 NULL도 일치로 취급한 비교
SELECT c.id FROM candidates AS c
WHERE NOT EXISTS (
  SELECT 1 FROM blocked AS b WHERE b.id IS c.id
)
ORDER BY c.id;
스키마 선언만 보고 NULL이 없다고 가정할 수 있는지도 확인했다. INTEGER UNIQUE 열에 NULL을 두 번 삽입했을 때 이 SQLite 실행에서는 모두 성공했고 NULL 행 수는 2였다. 따라서 이번 조건에서 UNIQUE 선언만으로 NULL이 없다고 볼 수는 없었다. 중복 제한과 NULL 허용 여부를 구분해서 확인해야 하며, 이 삽입 결과를 다른 데이터베이스의 UNIQUE 정책에 대한 증거로 쓰지는 않는다.
이 실험이 말하지 않는 것
확인한 범위는 SQLite 3.50.4의 스칼라 정수 열과 네 가지 작은 입력이다. 다른 데이터베이스와 복합 키, 문자열 정렬 규칙, 실제 데이터 분포, 실행 계획, 속도는 검사하지 않았다. 참고한 공식 문서 두 페이지도 같은 SQLite 프로젝트가 의미 규칙을 설명한 자료이므로 독립된 두 연구로 볼 수 없다. 로컬 재현에서는 그 규칙을 이번 쿼리 결과와 대조했으며 성능 벤치마크는 하지 않았다.
이 결과로 NOT EXISTS가 더 빠르다고 말할 수는 없다. 쿼리를 고치기 전에 왼쪽 NULL을 결과에 남길지, 오른쪽 NULL을 비교 대상에서 지울지, 두 NULL을 일치로 취급할지부터 정해야 한다. 그런 다음 빈 오른쪽 집합까지 포함한 기대 행 배열로 수정 전후를 비교할 수 있다. 이번 실험에서는 원래 NOT IN과 오른쪽 NULL 제거, 등호 기반 NOT EXISTS가 서로 다른 정책을 따른다고 판단했다. 제외 목록에 없다는 조건이 실제로 어떤 행을 뜻하는지 정해야 수정이 성공했는지도 확인할 수 있다.
Sources
[1] https://www.sqlite.org/lang_expr.html — SQLite expressions
[2] https://www.sqlite.org/lang_select.html — SQLite SELECT WHERE filtering