이 글의 영어 번역
This experiment follows KEV, JEV, LAYA and PPLX from initial setup through v12: evidence packets, monitoring, failed hooks, uncertain answers, quality checks and latency optimization.
Read the complete English article, including all tables and appendices
KEV·JEV·LAYA·PPLX를 시험하고, 판단 연동을 v12까지 고친 기록
긴 글을 쓰거나 코드를 만드는 일은 큰 모델에 맡기되, 작업 중간의 작은 판단은 더 빠른 모델이 처리하면 어떨까. 다음에 읽을 파일을 고르는 일, 여러 스킬 중 필요한 것을 찾는 일, 지금 확보한 근거로 작업을 끝내도 되는지 확인하는 일 같은 것들이다.
이 질문에서 시작해 KEV 0.8B·4B·8B, JEV API, LAYA, PPLX Decider 27B를 차례로 시험했다. 실제 운영 스킬을 바꾸어 비교했고, 판단 모델을 에이전트 전역에 연결했다. 이후에는 모델 성능보다 입력·훅·검증·기록 방식에서 더 많은 문제를 발견했다. 연동 클라이언트는 v12까지 바뀌었다.
가장 빠른 모델이 가장 유용한 모델은 아니었다. 큰 모델이 작은 시험에서 전부 맞혔다고 실제 업무에서도 거의 100%라고 말할 수는 없었다. 판단 API가 100ms 안팎에 답해도 전체 작업은 오히려 길어질 수 있었다. 반대로 수초가 걸리는 모델도 같은 관찰 내용을 여러 질문에 재사용하면 기다리는 시간을 줄일 수 있었다.
현재 실험 구성은 KEV 0.8B와 PPLX 27B를 같은 판단 패킷으로 병렬 호출한다. 두 답을 비교하되 어느 한쪽을 자동으로 정답 취급하지 않는다. 짧은 설치 확인에서는 첫 호출이 2.829초, 같은 상태의 캐시 적중이 1.141초였다. 실제 업무에서 가져온 새 상태의 질문은 대체로 그보다 오래 걸렸다.
이 글은 그 구성을 처음부터 설계한 성공 사례가 아니다. 무엇을 시험했고, 어떤 수치를 잘못 읽기 쉬웠으며, 실패를 어떻게 구분하고 수정했는지 정리한 실험 기록이다. 측정과 구현 상태는 2026년 10월 3일에 확인한 기록을 기준으로 한다.
1. 글을 만드는 모델과 판단하는 모델을 나누고 싶었다
에이전트가 하는 일을 보면 결과물 작성 사이에 짧은 선택이 계속 끼어 있다. 서버 상태를 확인한 뒤 로그를 더 읽을지, 기존 자동화가 있는지부터 찾을지, 테스트 결과를 배포 근거로 삼을지, 자료가 부족하니 확인을 요청할지 결정한다. 이런 선택 하나 때문에 주 모델이 길게 생각하는 경우도 있다.
여기서 기대한 것은 문서 작성이나 디버깅 자체를 작은 모델로 대체하는 일이었다기보다, 선택지를 충분히 좁힌 뒤 다음 행동을 빠르게 정하는 일이었다. 예를 들어 “이 시스템을 고쳐라”는 너무 크다. “현재 오류와 파일 상태가 이렇다면, 우선 디렉터리 충돌을 확인할지 네트워크 상태를 확인할지”는 작은 질문으로 만들 수 있다.
KEV, TypeSafe의 JEV, LAYA, PPLX Decider는 이 실험의 후보였다. 공통적으로 자연어 상태와 질문을 넣고 제한된 형태의 판단을 받는 접근에 관심이 갔다. 모델마다 구현과 지원 범위는 달라서 비슷한 인터페이스가 같은 성능이나 확률 의미를 보장하지는 않는다.
실험에서는 주로 선택형 질문을 사용했다. 입력은 관찰한 상태, 하나의 판단 질문, 실제 행동을 설명하는 선택지로 구성했다. 답은 선택지와 분포로 받았다. 일반 채팅 모델에 장문의 설명을 요구한 뒤 마지막 문장을 파싱하는 방식과는 작업 형태가 달랐다.
처음 세운 가설은 다음 정도였다.
- 판단이 작고 근거가 분명하면 0.8B도 실용적일 수 있다.
- 판단 모델의 응답이 빨라도 입력 작성과 검증 비용 때문에 전체 작업은 빨라지지 않을 수 있다.
- 모델 크기를 늘리면 품질이 나아질 가능성은 있지만, 로컬 메모리와 지연 비용도 커진다.
- 같은 모델이라도 질문과 선택지를 잘못 구성하면 좋은 답을 기대하기 어렵다.
이 가설들을 확인하려면 쇼핑 추천 같은 예제를 많이 만드는 것보다 이미 하는 일을 가져오는 편이 낫다고 판단했다. 그래서 첫 대상은 LAN 호스트와 서비스를 점검하는 운영 스킬이었다.
2. 먼저 실제 운영 스킬을 바꾸어 비교했다
첫 실험에서는 기존 스킬과 판단 모델을 넣은 후보 스킬을 분리했다. 읽기 전용으로 서비스와 프로세스 상태를 확인하고, 확보한 근거로 다섯 가지 주장을 평가했다.
| 확인할 주장 | 필요한 관찰 | 당시 참조 판정 |
|---|---|---|
| 모델 API 프로세스가 실행 중인가 | 해당 프로세스의 관찰 결과 | 근거 있음 |
| 웹 UI 또는 모델 프록시의 HTTP 응답이 있는가 | 해당 주소의 HTTP 결과 | 근거 있음 |
| 추론 요청이 완료됐는가 | 실제 추론 요청과 반환 결과 | 근거 있음 |
| 지정한 에이전트 런타임이 실행 중인가 | 대상 런타임의 프로세스 결과 | 근거 있음 |
| 메시지 전달까지 확인했는가 | 발송과 수신을 확인할 결과 | 확인되지 않음 |
마지막 항목이 중요했다. 프로세스가 실행 중이라는 사실로 메시지가 전달됐다고 말할 수는 없다. 이 시험에서는 메시지를 보내지 않았고 전달 영수증도 없었다. 웹 서비스의 HTTP 응답 역시 브라우저에서 모든 기능이 정상 동작했다는 의미는 아니었다.
기존 스킬의 전체 실행과 KEV 0.8B·4B, JEV를 넣은 실행을 각각 관찰했다.
| 스킬 구성 | 전체 실행 시간 | 해당 실행에서 판단 모델의 최초 판정 | 최종 답변의 다섯 주장 |
|---|---|---|---|
| 기존 스킬 | 167.070초 | 해당 없음 | 5/5 일치 |
| KEV 0.8B 후보 | 174.990초 | 4/5 일치 | 5/5 일치, 한 항목 수정 |
| KEV 4B 후보 | 181.871초 | 새로 수집한 근거에서 5/5 일치 | 5/5 일치 |
| JEV 후보 | 188.015초 | 새로 수집한 근거에서 5/5 일치 | 5/5 일치 |
각 구성을 한 번씩 실행한 결과다. 읽은 자료, 도구 사용 전략, 런타임 상태와 대기 시간이 같지 않았다. 따라서 이 표는 판단 모델을 붙인 실행의 실제 모습을 보여주지만, 어느 모델이 전체 작업을 몇 퍼센트 빠르게 한다는 비교 실험은 아니다.
관찰된 범위에서 KEV 0.8B 실행은 기존 실행보다 7.920초 길었다. 판단 모델을 넣으면 자동으로 빨라질 것이라는 기대와는 달랐다. 기존 실행은 셸 호출 11회였고 0.8B 후보는 15회였다. 판단 입력을 준비하고 결과를 확인하는 작업이 더해졌다. 최종 품질을 지킨 데도 주 모델의 검수가 필요했다.
이때 0.8B의 첫 판단 요청은 2.433초가 걸렸다. 모델은 전달 확인이 없는 마지막 주장에 대해 참 쪽 값을 0.5127로 반환했다. 당시 단순한 0.5 경계를 적용하면 “전달됨”으로 분류할 수 있는 값이다. 주 모델이 원래 관찰 결과와 대조해 이를 수정했다.
0.5127은 아주 확실한 판단처럼 보이지 않지만, 숫자를 이진 결정으로 바꾸는 순간 실제 결론이 된다. 이 경계는 업무별로 보정한 정책이 아니었다. “점수가 나왔다”와 “실행해도 되는 판단이 검증됐다” 사이에 간격이 있다는 것을 처음 확인한 사례였다.
같은 관찰 묶음을 고정하면 결과가 달랐다
전체 스킬 실행은 매번 근거를 새로 수집했다. 모델 판단만 더 가깝게 비교하기 위해 실제 점검에서 나온 관찰 묶음 두 개를 고정해 다시 넣었다.
| 모델 | 관찰 묶음 A의 다섯 주장 | 관찰 묶음 B의 다섯 주장 |
|---|---|---|
| KEV 0.8B | 4/5 일치 | 3/5 일치 |
| KEV 4B | 3/5 일치 | 5/5 일치 |
| KEV 8B | 4/5 일치 | 3/5 일치 |
JEV jev-1.13.0 | 4/5 일치 | 4/5 일치 |
두 묶음은 비슷한 서비스를 점검한 기록이다. 다섯 주장씩 있다고 열 개의 독립적인 문제를 무작위로 뽑은 것은 아니다. 그래도 “4B 또는 8B면 이 작은 업무에서 반드시 0.8B보다 낫다”는 기대를 지지하지는 않았다.
앞 표에서 4B와 JEV가 5/5였던 것과 모순되는 결과도 아니다. 새 스킬 실행에서 새로 모은 근거와 고정한 관찰 묶음은 다른 입력이었다. 이 차이를 지우면 시험 결과를 모델의 일관된 성능처럼 잘못 읽게 된다.
3. 0.8B, 4B, 8B와 JEV를 시험하고도 0.8B를 남긴 이유
0.8B를 선택한 이유는 처음부터 가장 정확해서가 아니었다. 로컬에서 빨리 호출할 수 있었고, 메모리 부담이 작았으며, 더 큰 모델이 이 시험에서 일관된 개선을 보이지 않았기 때문이다.
0.8B는 같은 관찰 내용을 다시 넣었을 때 약 0.331~0.350초가 걸렸다. 새 관찰 묶음은 2.888초였다. 반복 입력과 새 입력의 차이는 초반부터 컸다. 이때의 반복 응답이 빨랐다는 관찰만으로 내부의 어느 캐시가 얼마나 기여했는지는 확정할 수 없었다.
4B는 자원이 더 부족한 Mac에서 두 번 30초 제한에 걸렸다. 별도 추론 관찰에서는 81.01초가 걸린 적도 있었다. 모델 계산이 Metal 쪽에서 대기하는 모습과 큰 스왑 사용을 함께 관찰했지만, 이것만으로 시간 초과의 유일한 원인을 증명하지는 못했다. 입력을 만드는 단계가 실패해 판단 요청까지 가지 못한 경우도 있었다. 그런 실패는 모델이 틀린 답을 준 사례와 구분했다.
32GB 메모리의 다른 Mac에서는 4B가 실행됐다. BF16 구성의 첫 고정 입력은 10.625초, 반복 입력은 1.035~1.094초였다. 새 근거를 포함한 스킬 판단은 11.271초였다. 큰 모델을 띄울 수 있는지와 실제로 채택할 만큼 도움이 되는지는 별개의 질문이었다.
8B도 32GB Mac에서 시험했다. 첫 관찰 묶음은 22.659초, 두 번째 묶음은 25.306초였다. 반복 입력에서는 각각 약 1.9초와 2.0~2.2초였다. 여섯 요청은 완료됐지만 고정 근거에서의 일치 수는 0.8B보다 좋아지지 않았다.
여기서 8B는 당시의 별도 체크포인트였다. 0.8B·4B와 동일한 기반 모델 및 실행 경로에서 파라미터 수만 늘린 구성이 아니었다. 8B 시험은 Torch/MPS BF16 경로였고 작은 모델 시험과 백엔드도 달랐다. 현재 KEV 저장소에 소개된 모델 목록을 과거 시험 구성에 그대로 대입해서는 안 된다.
JEV API는 아주 빨랐다. 두 고정 근거를 반복한 여섯 요청의 중앙값은 272.0ms, 범위는 251.1~305.2ms였다. 이 시간에는 클라이언트와 통신이 포함되며 서버 내부 캐시 여부는 알 수 없었다.
그러나 두 근거 묶음에서 실제로 완료된 추론 요청을 인정하지 않는 판정이 반복됐다. JEV를 넣어 새로 실행한 스킬에서는 다섯 주장을 맞혔지만, 고정 입력 비교에서는 각각 4/5였다. 유료 API가 빠르고 잘 정돈되어 있다고 개별 업무의 정확성까지 보장되는 것은 아니었다.
이 시험에서는 실제 청구 내역을 확인하지 않았다. JEV의 비용 대비 효율을 숫자로 계산할 수는 없다. 로컬 KEV도 API 사용료가 없다는 이유만으로 비용이 0인 것은 아니다. 하드웨어, 전력, 상주 메모리, 설치와 유지보수 시간이 든다.
그래도 작은 반복 판단의 기본 후보로는 0.8B를 유지할 근거가 있었다. 선택은 “정확도가 충분히 증명됨”보다 “가벼운 기본 구성을 두고 실제 사용에서 검증해 보자”에 가까웠다.
4. 스킬 하나에서 전역 판단으로 넓히자 다른 문제가 나왔다
첫 스킬 시험이 끝난 뒤 목표는 더 커졌다. 특정 검증 스킬에서만 모델을 쓰는 것이 아니라, 에이전트가 중요한 선택을 할 때마다 로컬 판단 모델을 먼저 활용하도록 하고 싶었다.
대상은 여러 후보 중 선택, 자료 선별, 분류와 우선순위, 다음 행동, 추가 조사 여부, 간단한 완료 검수였다. 글 작성, 코딩, 복잡한 문제 해결과 최종 결과물 구성은 주 모델이 계속 담당했다.
초기에는 기존 검증 스킬에 관련 규칙을 넣는 방식으로 접근했다. 하지만 전역 판단이라는 요구를 검증 스킬 하나에 묶는 것은 범위가 맞지 않았다. 독립적인 판단 스킬을 만들고 전역 지침과 기본 지침에 연결했다. Codex와 Hermes의 생명주기 훅도 함께 사용했다.
훅은 프롬프트 제출, 도구 사용 전후, 모델 호출 전처럼 런타임이 노출하는 이벤트에서 실행된다. 이런 이벤트가 에이전트의 모든 판단을 나타내지는 않는다. 어떤 내부 생각이 발생하는 순간을 일반적인 설정 훅이 완전히 가로채는 구조도 아니다.
그래서 전역 지침, 스킬, 훅을 함께 넣더라도 모든 판단이 반드시 모델을 통과한다고 보장할 수는 없었다. 가능한 범위에서 상담을 상기시키고 실제 상담을 기록하는 구조였다. “설치되어 있다”, “신뢰 설정을 통과했다”, “현재 열린 GUI 세션이 이를 적용했다”, “실제 판단에서 호출했다”는 서로 다른 확인 항목이었다.
이 구분은 뒤의 장애 분석에서도 중요했다. 새 CLI 프로세스의 훅 신뢰 확인이 성공했다고 이미 열려 있던 앱 세션의 설정 적용까지 검증됐다고 말하면 안 됐다.
첫 모니터링에서 92.7%가 근거 부족이었다
설치와 시험 작업이 많이 섞인 초기 Windows 관찰에는 호출 561건이 있었다. 상담 성공은 559건이고, 그중 518건이 insufficient_evidence였다. 성공한 상담을 분모로 하면 92.7%다. 두 건은 별도 차단으로 기록됐다.
응답 시간 중앙값은 675ms, p95는 1,286.7ms였다. 호출은 꽤 빨리 돌아왔다. 하지만 거의 매번 근거 부족이면 실제 다음 행동을 정하는 데 도움이 된다고 보기 어려웠다.
이 92.7%를 모델 오류율이라고 부르지는 않았다. 입력에 필요한 근거가 없었을 수 있고, 판단하기 어려운 질문에 적절히 기권했을 수도 있다. 다만 호출을 붙였다는 것만으로 목적을 달성한 것은 명백히 아니었다.
당시 훅은 생명주기 이벤트를 보고 일반적인 다음 행동을 묻는 성격이 강했다. 실제 작업의 결정적인 관찰과 구체적 선택지를 충분히 전달하지 못했다. 모델이 판단할 만한 문제를 만들어 주지 않은 셈이었다.
5. 문맥을 늘리는 것만으로는 해결되지 않았다
v2에서는 현재 요청과 보이는 도구 결과 등 작업 문맥을 더 전달했다. 이전에 빠져 있던 이력을 넣으면 모델이 판단할 수 있을 것이라고 기대했다.
세 개의 실제 과거 요청으로 재현했다. 이벤트 정보만 있는 입력은 세 개 모두 기권했다. 이력을 넣은 후보도 세 개 모두 기권했다. 이력 포장 구조를 바꾼 버전 역시 세 개 모두 기권했다.
이벤트 입력은 약 460~470ms였고 이력을 넣은 후보는 약 1.2~1.4초였다. 더 많은 문맥을 보냈지만 판단이 나아지지 않고 기다리는 시간은 늘어난 것이다. 선택지 구성도 함께 바뀐 재현이므로 이를 문맥 길이만의 통제 실험으로 해석할 수는 없었다.
같은 작업에서 실제로 판단할 한 항목을 분리해 묻는 입력은 다른 양상을 보였다. 중요한 것은 대화 전체를 많이 전달하는 일이 아니라, 어떤 사실이 어떤 선택지를 구분하는지 보존하는 일이었다.
예를 들어 “도구 사용 이후 다음 행동은 무엇인가”만 물으면 조사, 수정, 완료 중 무엇을 선택할지 결정할 근거가 빈약하다. 현재 오류가 파일과 디렉터리의 충돌이고, 재시도는 이미 예약되어 있으며, 먼저 충돌을 해소해야 한다는 관찰을 주면 질문을 분리할 수 있다. “재시도가 없는가”와 “충돌을 수정해야 하는가”는 따로 평가할 수 있는 문제다.
이 경험 때문에 v3에서는 훅의 역할을 바꾸었다. 훅은 판단이 필요할 때 구체적인 상담을 수행하라는 짧은 체크포인트가 됐다. 생명주기 이벤트만으로 모델에 일반적인 질문을 던지는 작업은 중단했다.
실제 상담은 주 모델이 보이는 근거를 모아 명시적인 판단 패킷을 만들 때 발생한다. 모델 호출 없이 나온 체크포인트를 상담 건수나 기권 건수에 넣지 않도록 집계도 분리했다.
6. v1에서 v12까지, 실제로 무엇을 고쳤나
이 글의 v1~v12는 모델 학습 버전이 아니다. 판단을 요청하고 결과를 기록하는 연동 클라이언트와 지침의 변화다. 초반 구성은 현재처럼 모든 버전 표기가 정교하게 정리된 상태는 아니었다. 아래 표는 초기 연동부터 남아 있는 배포·수정 기록을 기능별로 정리한 것이다.
| 단계 | 발견한 문제 | 반영한 변경 | 이 변경으로 아직 증명하지 못한 것 |
|---|---|---|---|
| 초기 연동 | 생명주기 이벤트에서 일반적인 질문을 반복 | 로컬 모델 상담, 전역 지침·스킬·훅 연결 | 실제 모든 판단의 상담 여부 |
| v2 | 작업 문맥이 부족하거나 포장되어 전달됨 | 보이는 요청·도구 이력과 문맥 버전 기록 | 문맥 증가만으로 판단 개선 |
| v3 | 체크포인트와 실제 상담이 섞임 | 훅은 알림, 구체적 패킷은 별도 상담으로 분리 | 모든 내부 판단의 관찰 |
| v4 | 실패와 후속 결과의 원인이 불명확 | 단계별 진단, 읽을 수 있는 패킷, 후속 기록 | 기록만으로 독립적 정답 검증 |
| v5 | 질문 목록·입력 사용 방식이 어긋남 | 명시적 ID 목록 지원과 입력 검증 정리 | 문법 호환성으로 의미 정확성 보장 |
| v6 | 후속 파일 입력과 실제 선택지 위치를 잘못 사용 | 후속 입력 수정, 지원하지 않는 질문 필드 거부 | 순서에 따른 판단 변화 해소 |
| v7 | 검증 실패와 통신 실패를 한데 묶음 | 검증 전용 실행과 상담 분리, 통신 오류 유형 구분 | 오류 유형만으로 장애 원인 확정 |
| v8 | 파일 생성 실패 뒤 요청을 계속 실행 | 파일 오류 구분, 준비·검증 성공 뒤에만 제출하도록 지침 수정 | 런타임 전체에서 의존 실행 강제 |
| v9 | 채택·도구 성공을 정답처럼 집계 | 판단 ID와 행동·요구사항 참조 연결, 결과 집계 분리 | 성공한 행동의 비교 우위 |
| v10 | 명시적으로 금지한 선택지가 모델에 남음 | 출처 있는 금지 선택지를 추론 전에 제외 | 모델의 제약 이해 능력 향상 |
| v11 | 과거 실패의 원본 입력을 재검토하기 어려움 | 검토한 요청·답·후속 자료를 소유 런타임에 제한적으로 보관 | 사례 파일 존재만으로 정확성 보장 |
| v12 | 작은 모델의 판단을 더 강한 모델과 비교하고 싶음 | KEV와 PPLX에 같은 패킷을 병렬 제출, 답·지연·불일치 분리 | 두 모델의 동의로 정답 또는 작업 절감 보장 |
한 번에 기능을 설계해 넣었다기보다 실제 호출과 사용자 화면에서 발견한 문제를 차례로 고친 과정이었다. 그중 상당수는 판단 품질 향상보다 요청을 올바르게 보내고 결과를 정직하게 해석하기 위한 수정이었다.
요청 형식을 고친 일도 개선인가
모델이 읽지 않는 options 필드에 선택지 설명을 넣거나, 후속 검토 값을 문자열 대신 객체로 보내면 잘못된 요청이다. 오류를 자세히 구분하고 사전에 막는 작업은 분명 개선이다. 사용자는 원인을 빨리 찾을 수 있고, 실패한 준비 작업이 불필요한 모델 호출로 이어지는 것을 줄인다.
하지만 이 수정으로 모델의 의미 판단 능력이 올라갔다고 말할 수는 없다. 모델이 더 잘 생각하게 된 것과 필요한 입력을 처음으로 제대로 전달한 것은 구분해야 한다.
v6에서 확인한 과거 두 건의 invalid_arguments도 실제 추론 실패가 아니라 후속 결과를 기록하는 명령의 문제였다. 이를 모델 오류율에 넣으면 의미 없는 수치가 된다. v7에서는 검증만 하는 실행이 상담이나 실패 집계에 들어가지 않도록 고쳤다.
v8은 파일이 없거나 디렉터리이거나 읽을 권한이 없거나 읽기에 실패한 경우를 구분했다. 입력 파일을 만드는 프로그램이 실패했는데 다음 명령으로 제출을 진행한 사례가 계기였다. 파일 준비, 로컬 검증, 네트워크 제출은 앞 단계가 성공한 뒤 진행해야 했다. 지침은 이를 요구하지만 에이전트가 실행하는 모든 셸 명령을 강제로 가로채는 장치는 아니다.
질문을 잘못 쓰면 큰 모델도 난처하다
질문의 ID가 retry_status라고 되어 있어도 실제 질문 문장이 애매하면 도움이 되지 않는다. 질문은 ID를 보지 않아도 의미가 성립해야 한다. 선택지는 그 행동을 실제로 설명해야 한다.
“현재 상태를 무시하는 잘못된 수정”과 “권장되는 안전한 수정”처럼 평가가 섞인 이름을 붙이면 모델에게 결론을 유도하는 셈이다. 실제 행동을 중립적으로 설명하고, 요구사항과 관찰을 상태에 넣는 편이 낫다.
스킬 선택도 마찬가지였다. 이름만 보고 하나를 찍게 하는 대신 실제 후보의 설명과 관련 지침을 읽어야 했다. 한 작업에 여러 스킬이 적용될 수 있으므로 하나만 고르는 질문으로 억지로 합치지 않도록 했다. 적용할 스킬이 없는 경우도 허용했다.
지침을 계속 추가하는 데도 한계가 있었다. 한 런타임에서는 기본 지침이 21,020자로 늘어 20,000자 제한을 넘었고, 정상 검증에서 변경이 되돌려졌다. 같은 내용을 버전별로 중복 설명한 부분을 정리해 7,087자로 줄인 뒤 다시 검증했다. 이 수정은 토큰 절감을 측정한 결과가 아니라, 지침이 런타임의 허용 범위 안에 실제로 들어가도록 한 수정이었다.
이 방향을 검토할 때 TypeSafe의 공식 스킬을 참고했다. 구조화된 판단을 코드에서 조합하는 접근을 배우되, 예제의 JEV 임계값을 로컬 KEV의 검증된 정책처럼 가져오지는 않았다.
omo-jev-plugin도 검토했다. 외부 플러그인을 통째로 추가하는 대신, 판단을 실제 행동과 후속 결과에 연결하는 방향을 현재 구조에서 검토했다. 외부 코드의 신뢰도 기준이나 재시도 규칙이 우리 시험에서 검증된 것은 아니므로 그대로 도입하지 않았다.
7. 모델 실패처럼 보인 훅 오류의 실제 정체
운영 중 화면에 hook exited with code 127이 반복해서 나타났다. 직접 확인하니 별도 OMX 훅이 존재하지 않는 과거 Node 실행 파일 경로를 가리키고 있었다. Node 업그레이드 뒤 버전 디렉터리 경로가 오래된 채 남아 있었던 것이다. 무해한 버전 확인 명령으로도 같은 127을 재현했다.
이 경우는 KEV 모델이 틀린 판단을 했거나 응답을 거부한 문제가 아니었다. 훅을 실행할 명령 자체를 찾지 못했다. 요청에 따라 불필요한 OMX 연동을 제거하고 확인했다. 다만 화면의 개별 실패 행은 화면 정보만으로 모두 같은 훅이라고 단정할 수 없었다.
다른 시점에는 PreCompact와 PostCompact 훅에서 잘못된 JSON 출력 오류가 발생했다. 이쪽은 별도 기록 훅이 해당 이벤트가 받아들이지 않는 문맥 출력 형식을 반환한 문제였다. 성공 시 기록은 보존하고 stdout을 비우도록 수정했다. 설정된 명령의 분리 시험은 통과했지만 이미 열린 대화의 다음 자연스러운 압축 이벤트까지 관찰한 것은 아니었다.
왜 이런 문제를 모델 실험에 포함하는가. 판단 모델을 에이전트에 붙여 쓰는 사람에게는 훅 실행 실패, 신뢰 설정, 입력 검증, 통신, 추론, 후속 기록이 모두 같은 실패 화면으로 보이기 쉽기 때문이다. 각각의 층을 나누지 않으면 모델을 바꾸어도 원래 문제는 남는다.
| 실패 층 | 예시 | 확인할 것 |
|---|---|---|
| 실행 명령 | 오래된 실행 파일 경로, 종료 코드 127 | 실제 파일과 설정 명령의 실행 결과 |
| 훅 출력 | 이벤트에 맞지 않는 JSON | 해당 이벤트의 출력 계약 |
| 신뢰·적용 | 등록은 됐지만 실행 허용 또는 현재 세션 적용이 불명확 | 새 프로세스와 현재 세션을 구분한 확인 |
| 로컬 준비 | 파일 없음, JSON 생성 실패, 잘못된 필드 | 생산 단계와 검증 단계의 종료 상태 |
| 통신 | 시간 초과, 연결 거부, 연결 초기화, 이름 해석 실패 | 어느 요청 단계에서 발생했는지 |
| 모델 판단 | 근거와 충돌하는 선택, 순서에 따라 달라지는 답 | 동일한 원본 패킷과 실제 요구사항 |
| 결과 기록 | 후속 명령 실패, 연결할 판단 ID 없음 | 원래 상담 ID와 기록 성공 여부 |
통신 오류 이름이 자세해진 것만으로 원인이 해결되는 것은 아니다. connection_refused는 실패 유형을 말해 준다. 서비스가 꺼졌는지, 주소가 틀렸는지, 다른 전제조건이 빠졌는지는 추가 확인이 필요하다. 원인을 모르는 상태에서 제한 시간을 늘리고 자동 재시도를 넣는 방식은 채택하지 않았다.
8. 제약과 후속 결과를 기록하는 방법도 바꿨다
작은 모델은 요구사항을 분명히 적어도 어기는 선택지를 고를 수 있었다. v10에서는 사용자가 명시적으로 금지한 행동을 모델에 묻기 전에 제외할 수 있게 했다.
예를 들어 기존 명단을 보존하라는 요구가 있는데 명단을 즉시 교체하는 선택지가 있다면, 그 선택지는 요구사항을 인용해 제외할 수 있다. 불확실성 선택지는 남긴다. 금지 후 구체적인 선택지가 하나도 없으면 사전 검증에서 멈춘다.
이는 모델의 이해 능력을 높인 기술이 아니다. 호출자가 명시적인 조건을 강제하는 방식이다. 선호하는 답을 얻기 위해 경쟁 선택지를 제거해서도 안 된다. 잘못된 제외 선언은 유효한 답까지 없애므로 제외 근거도 검토 대상이다.
여섯 개의 저장 사례를 세 가지 선택지 순서로 시험한 필터 적용 결과는 18개 중 참조 일치 9개, 기권 9개, 잘못된 구체적 선택 0개였다. 선택지 집합이 달라졌으므로 원래 질문의 정확도가 올랐다고 환산할 수는 없다. 수동으로 다시 쓴 개발 질문에서 좋은 결과를 얻은 것도 같은 이유로 따로 보관했다.
v9에서는 판단 후 adopted, overridden, deferred를 기록하고 실제 도구 결과와 요구사항의 참조를 연결했다. 채택은 에이전트가 따랐다는 뜻이고, 도구 성공은 실행이 성공했다는 뜻이다. 둘 다 답의 정확성을 자동으로 증명하지 않는다.
기권 뒤 주 모델이 행동을 정해 작업을 성공시켰다고 해서 기권이 오답인 것도 아니다. 당시 패킷에 실제로 충분한 사실이 있었는지, 둘 이상의 유효한 선택지가 남아 있었는지 확인해야 한다.
여러 질문을 한 번에 물었는데 한 답은 맞고 한 답은 틀렸다면 배치 전체를 정답으로 기록하면 안 된다. 구체적 선택과 기권이 섞인 경우도 분리해야 한다. 후속 결과는 원래 판단 ID에 연결하고, “최근 호출”이라는 이유로 다른 작업의 판단에 붙이지 않도록 했다.
v11에서 검토한 입력과 답을 소유 런타임에 제한적으로 보관한 이유도 이 때문이다. 해시만 있으면 동일성은 확인할 수 있지만, 무엇이 부족했고 왜 틀렸는지 다시 읽을 수 없다. 사례 보관은 호출자가 자료를 검토한 경우에만 선택하도록 했다. 단순 패턴 검사만으로 비밀정보가 완전히 제거된다고 보장하지 않았다.
또한 설치 시험이 일반 업무로 잘못 기록된 사례를 찾아 원본을 보존한 채 시험 출처를 수정했다. 그런 기록을 업무 사용량이나 정확도에 포함하면 설치를 열심히 할수록 성과가 좋아 보이는 이상한 지표가 된다.
9. LAYA는 빨랐지만, 이 업무 묶음에서는 채택하지 않았다
다른 가벼운 판단 모델도 시험하고 싶어 LAYA를 32GB Mac에 임시 설치했다. 사용한 패키지는 laya 0.3.21, 체크포인트는 convaiinnovations/laya-multilingual이었다. Torch 2.8.0과 Transformers 5.17.0의 MPS 경로로 실행했다.
설치 파일은 약 659.9MiB였고 모델 로딩은 3.826초, 첫 추론은 2.133초였다. 관찰된 프로세스 최대 RSS는 약 2.64GiB, MPS 드라이버 할당은 약 1.28GiB였다. 통합 메모리를 사용하는 환경이므로 이 값을 서로 독립적인 메모리 사용량처럼 더하지 않았다.
첫 비교는 실제 작업 세 개에서 원래 질문과 좁힌 사실 질문을 만들고, 선택지 순서를 두 가지로 바꾸어 진행했다. 모델당 12회 요청이지만 독립 사례 12개는 아니다. 좁힌 여섯 질문에서 LAYA는 3개, KEV는 5개가 참조와 일치했다.
첫 호출을 제외한 중앙값은 LAYA 66.0ms, KEV 106.7ms였다. 다만 LAYA는 프로세스 안에서 직접 실행했고 KEV는 원격 HTTP 경로였으므로 이 차이를 모델 자체의 계산 속도 차이로 단정할 수는 없다.
LAYA는 명단 생성·비활성화를 금지한 조건에서 즉시 교체를 고르거나, 첫 실행이 아직 확인되지 않았는데 업데이트가 끝났다고 답한 사례가 있었다. KEV도 선택지 순서를 바꾸었을 때 업무 범위를 잘못 고른 사례가 있어 한쪽만 문제가 없는 비교는 아니었다.
더 시험할 필요가 있어 쇼핑 예제가 아니라 운영 진단, 재시도, 명단 보존, 접근 범위, 완료 판단 같은 업무에서 23개 개발 사례를 작성했다. 그중 7개는 정답을 정할 근거가 부족해 채점하지 않았다. 나머지 16개 중 하나는 정리 과정에서 중요한 조건이 빠져, 그 항목을 제외한 15개를 더 보수적인 비교로 보았다.
| 중요한 조건을 보존한 15개 개발 질문, 세 가지 순서 | LAYA | KEV 0.8B |
|---|---|---|
| 참조와 일치 | 2/45 | 27/45 |
| 참조와 다른 구체적 선택 | 19/45 | 6/45 |
| 기권 | 24/45 | 11/45 |
| 실행 실패 | 0/45 | 1/45 |
| 세 순서 모두 참조에 일치한 질문 | 0/15 | 7/15 |
전체 23개에서 세 순서로 실행한 속도 관찰은 LAYA의 성공한 69개 요청 중앙값 62.680ms, p95 118.192ms였다. KEV는 성공한 67개 요청 중앙값 134.6ms, p95 248.9ms였고 두 요청의 실행 실패가 있었다. 속도 표의 분모와 앞의 채점 표 분모가 다르다.
이 결과로 LAYA 전체의 일반 성능을 결론낼 수는 없다. 특정 다국어 체크포인트와 당시 기본 실행 경로를, 직접 작성한 작은 업무 묶음에서 시험한 것이다. 임계값을 별도로 보정하거나 학습을 추가한 것도 아니다. 현재 문서에 있는 다른 LAYA 변형을 시험한 결과도 아니다.
그래도 이 구성의 채택 여부를 정하는 데는 충분했다. 빨랐지만 업무 조건을 보존하는 판단에서 기대한 결과가 나오지 않았다. 임시 런타임과 체크포인트를 제거했고 결과 기록은 남겼다. 생산 훅에는 LAYA를 넣지 않았다.
10. PPLX 27B는 Mac에서 어떻게 실행했나
다음 후보는 PPLX Decider v1 27B였다. 이름에 27B가 붙는 만큼 작은 판단 모델과는 자원 규모가 달랐다. 원본 다운로드 대상은 52,193,565,570바이트, 약 52.19GB였다. 공유 회선 부담을 줄이기 위해 다운로드 속도를 초당 5,000,000바이트로 제한했다.
실행 대상은 32GB 통합 메모리의 M4 Mac이었다. 원본 가중치를 그대로 올리는 대신 텍스트 경로를 MLX로 옮기고 affine 4-bit, group size 64로 변환했다. 변환 후 가중치 파일은 14,420,466,057바이트, 약 14.42GB였다.
이 모델을 일반적인 대화 모델처럼 연결해서 긴 문장을 생성하게 한 것은 아니다. 원본의 판단용 readout을 사용해 선택지 분포를 얻었다. 255×5120 BF16 readout은 값과 dtype을 보존해 양자화하지 않았다.
이식 과정에서 작은 네 층 FP32 모델을 Torch와 MLX로 비교했다. 길이 1, 17, 256에서 최대 절대 오차는 3.10e-6 이하였다. 양자화한 가중치의 재로딩과 readout 보존 확인도 통과했다.
하지만 작은 모델의 수치 일치가 전체 27B의 BF16 실행과 4-bit 실행이 의미적으로 같다는 증거는 아니다. 전체 모델을 원본 BF16으로 실행해 동일한 사례를 비교하지 않았으므로 양자화에 따른 판단 품질 변화는 분리해 측정하지 못했다. 원본 모델의 이미지 경로도 이 실험에서는 옮기거나 시험하지 않았다.
설치 확인의 368토큰 입력은 추론에 6.267초가 걸렸고 모듈 import 이후 모델 로딩을 포함하면 12.417초였다. 처음에는 매번 CLI 프로세스가 모델을 새로 읽는 구성으로 확인했다. 이후 실험에서는 모델을 한 번 로딩하고 반복 사용했다.
관찰된 활성 모델 할당은 약 14.421GB였다. 추가 검증에서 최대 활성 할당은 14.952GB, 질문 이후 관찰한 활성 할당과 MLX 캐시의 합은 최대 21.474GB였다. 이는 전체 운영체제 메모리 사용량이 아니다. CPU RSS와 그대로 더할 수도 없다.
실험 전후 스왑 수치가 같았던 구간도 있었다. 그러나 시작과 끝의 값만으로 중간에 스왑이 전혀 없었다고 증명할 수는 없다. 32GB에서 짧은 텍스트 요청이 돌아갔다는 결론까지는 가능하지만, 긴 문맥과 여러 상주 서비스를 함께 쓰는 환경의 안정성을 보장하는 결과는 아니다.
11. 처음에는 거의 전부 맞혔다. 원본 요청으로 돌아가니 달라졌다
PPLX와 KEV에는 같은 직렬화 패킷을 넣었다. 각 모델의 토크나이저와 내부 프롬프트 형식은 달라도 상태, 질문, 선택지는 같게 유지했다. 이 비교는 선택지 제외 기능을 쓰지 않은 원래 후보 집합으로 진행했다.
먼저 LAYA 비교 때 작성했던 23개 개발 사례를 사용했다. 그중 참조를 정할 수 있는 16개 질문에서 PPLX는 원래 선택지 순서로 16/16을 맞혔다. 순서를 원래대로, 역순으로, 회전해 실행한 결과도 48/48이었다. KEV는 원래 순서 8/16, 세 순서 합계 27/48이었다.
| 이전에 작성한 개발 질문 | PPLX 27B 4-bit | KEV 0.8B |
|---|---|---|
| 원래 순서의 참조 일치 | 16/16 | 8/16 |
| 세 순서의 참조 일치 | 48/48 | 27/48 |
| 전체 질문 실행의 기권 | 4/69 | 18/69 |
| 순서에 따라 선택이 바뀐 질문 | 1/23 | 8/23 |
좋은 결과였다. 동시에 과대해석하기 쉬운 결과였다. 48개는 독립 문제 48개가 아니라 같은 질문 16개를 세 순서로 평가한 것이다. 개발 사례는 사람이 정리한 질문이며, 이미 앞선 시험에 쓰인 자료도 있었다. 업무 전체를 무작위로 뽑아 독립 평가자가 채점한 데이터가 아니었다. 앞의 LAYA 보수적 비교에서 제외했던 조건 손실 사례도 이 16개 집계에는 포함되어 있다. 따라서 48/48은 작성된 패킷의 참조 일치로 한정해 읽어야 한다.
원본 요청을 가져오면 결과가 유지되는지 추가로 확인했다. 과거에 실제 제출한 판단 패킷 다섯 개를 문장과 관찰을 다시 쓰지 않고 고정했다. 한 패킷에 질문 두 개가 있어 총 여섯 질문이었다. 이 중 참조를 정할 수 있는 질문은 네 개였다.
| 다시 쓰지 않은 원본 요청의 질문 | PPLX 27B 4-bit | KEV 0.8B |
|---|---|---|
| 원래 순서의 참조 일치 | 3/4 | 0/4 |
| 세 순서의 참조 일치 | 9/12 | 4/12 |
| 전체 질문 실행의 기권 | 3/18 | 2/18 |
| 순서에 따라 선택이 바뀐 질문 | 0/6 | 4/6 |
이 원본 묶음에도 선택 편향이 있다. 앞서 KEV가 틀렸던 사례를 일부러 포함했으므로 일반 업무에서 KEV가 이 비율로 틀린다고 말할 수는 없다. PPLX의 3/4 역시 일반적인 75% 정확도 추정치가 아니다.
PPLX는 동시 실행과 진단의 간섭을 확인하는 선택, 이미 존재하는 재시도 일정, 디렉터리와 파일의 충돌을 처리하는 선택을 잘 구분했다. 반면 권위 있는 명단과 웹 표시가 다른 경우에는 세 순서 모두 기권했다. 원래 요구사항에서 명단 보존이 참조였기 때문에 일치하지 않았지만, 잘못된 구체적 수정 행동을 선택한 경우와는 구분했다.
두 묶음을 합친 모델당 84회 요청은 모두 실행을 완료했다. 이 숫자는 실행 성공 수이고 독립 정확도 사례 수가 아니다. 원본 요청, 사람이 다시 쓴 개발 질문, 채점하지 못한 질문을 합쳐 하나의 정답률로 만들지 않았다.
더 어려운 변형을 넣으면
좋은 결과를 확인한 뒤 원본 업무 세 개에서 12개 스트레스 변형을 만들었다. 질문은 15개였다. 오래된 가설을 함께 넣거나, 결정적인 관찰을 제거하거나, 현재 영수증을 다른 내용으로 바꾸거나, 인용문 안에 지시를 넣거나, 중요하지 않은 과거 기록을 길게 반복했다.
영수증을 바꾼 변형은 가정한 상황이다. 실제 운영에서 그런 사건이 발생했다고 기록한 것은 아니다. 제안된 행동도 실행하지 않았다.
| 업무 기반 스트레스 질문 | PPLX 27B 4-bit | KEV 0.8B |
|---|---|---|
| 원래 순서의 참조 일치 | 12/15 | 8/15 |
| 세 순서의 참조 일치 | 36/45 | 24/45 |
| 순서에 따라 선택이 바뀐 질문 | 0/15 | 4/15 |
| 기권 | 12/45 | 15/45 |
| 기권이 참조인 실행에서 일치 | 6/9 | 8/9 |
PPLX가 원래 순서에서 맞히지 못한 세 항목도 확인했다. 명단 보존 문제에서는 다시 기권했다. 결정적 관찰을 제거한 질문에서는 진단 선택을 골랐다. 재시도가 비활성이라는 조건으로 바꾼 질문에서는 기권했다.
이 중 두 변형은 질문 자체에도 한계가 있었다. 근거를 지운 질문 문장에는 여전히 특정 진단이 언급되어 있었고, 재시도가 없다는 선택지에는 추가 예약 행동까지 함께 들어 있었다. 사전에 정한 참조 불일치는 그대로 남겼지만, 이를 모두 실제로 잘못된 행동을 실행한 증거라고 부르지는 않았다.
이렇게 시험을 세게 할수록 모델만 평가하는 것이 아니라 문제의 품질도 함께 평가하게 된다. 참조를 모델 답을 본 뒤 바꾸면 결과를 좋게 만들 수 있으므로 참조는 유지하고 질문의 한계를 별도로 적었다.
인용된 지시와 반복 문맥이 이 작은 PPLX 묶음에서 선택지 순서 변화로 이어지지 않았다는 사실도 일반적인 프롬프트 주입 안전성의 증거는 아니다. 입력 순서의 안정성, 참조 일치, 보안 성질은 다른 항목이다.
12. PPLX가 느린 이유부터 확인했다
개발 질문에서 PPLX의 상주 상태 질문별 중앙값은 5.333초, p95는 7.246초였다. KEV의 클라이언트 전체 중앙값은 0.359초였고, 별도로 보고한 요청 시간 중앙값은 0.128초였다.
5.333초와 0.359초를 나누면 약 14.87배다. 0.128초와 비교하면 약 41.8배지만 그 경우에는 시간 경계가 더 다르다. 한쪽은 모델 질문 처리 시간이고 다른 쪽은 KEV가 보고한 요청 구간이다. 처음 느낀 “수천 배 차이”는 이 측정으로 뒷받침되지 않았다.
그래도 매 판단마다 5~7초가 더해지면 부담이 크다. 모델을 상주시켜 반복 로딩을 없애도 입력 전체를 계산하는 시간은 남았다. 긴 반복 문맥 1,907토큰은 약 31.5초가 걸렸다.
먼저 MLX 컴파일을 시험했다. 같은 모델을 상주시킨 상태에서 두 입력을 eager와 compiled로 번갈아 처리했고, 각 형태의 첫 실행은 따로 제외했다.
| 입력 길이 | eager 중앙값 | compiled 중앙값 |
|---|---|---|
| 278토큰 | 4.441초 | 4.469초 |
| 432토큰 | 6.759초 | 6.755초 |
실용적인 속도 개선은 확인하지 못했다. 이 결과는 현재 구현에서 컴파일이 별 도움이 없었다는 뜻이지 가능한 모든 구현 중 가장 빠르다는 뜻은 아니다.
432토큰 질문의 계산 범주도 동기화해 관찰했다. FFN은 4.860초, linear attention은 1.812초, full attention은 0.523초였다. 계측된 총 7.198초 중 FFN이 약 67.5%였다. 계측하지 않은 실행은 6.894초였으므로 계측 경계가 스케줄링과 시간에 영향을 준다.
이 값은 실제 GPU 커널 추적 결과나 하드웨어의 최대 성능 분석은 아니다. 그래도 Python 함수 호출 몇 개를 없애는 것보다 큰 모델의 입력 계산을 줄이는 쪽을 먼저 검토할 근거는 됐다.
한 단계 작은 PPLX 형제 모델도 찾았다. 당시 공식 제공 목록과 관련 검색에서는 더 작은 학습된 Decider 체크포인트를 찾지 못했다. 작은 일반 Qwen 모델을 가져온다고 같은 판단 모델이 되는 것은 아니다. 기반 모델 크기와 판단 head에 맞는 학습이 필요하다.
HF에 공개됐다고 커스텀이 막힌 것도 아니었다. 공개 학습 설정과 모델 구현을 확인했다. 이식과 양자화는 이미 수행했지만, 더 작은 모델로의 학습이나 증류는 시도하지 않았다. 공개 레시피의 정확한 학습 자료가 그대로 포함된 것도 아니므로 동일 모델 재현 가능성까지 주장할 수는 없다.
13. 같은 질답이 아니어도 공통 상태는 재사용할 수 있었다
캐시를 검토할 때 처음 든 의문은 반복 질답이 실제로 얼마나 있겠느냐는 것이었다. 운영 에이전트는 매번 다른 질문을 한다. 완전히 같은 답을 저장해 두는 캐시만으로는 효과가 작을 수 있다.
여기서는 답 캐시보다 공통 상태의 계산을 재사용하는 방식을 시험했다. 같은 관찰 묶음에서 재시도 여부와 파일 충돌을 각각 묻는다면 질문은 달라도 앞부분의 상태는 같다. 공통 prefix 재사용 자체는 기존 추론 시스템에도 있는 방식이다. 이번 구현의 관심은 그 방법을 해당 판단 모델의 로컬 텍스트 경로에 맞게 적용하는 데 있었다.
상태 prefix가 정확히 같은지 확인하고 그 계산 상태를 보관했다. 질문마다 보관 상태를 복사해 독립적인 분기를 만들었다. 이 모델의 경로에는 recurrent state와 KV cache가 함께 있어 질문 하나를 처리한 상태를 그대로 다음 질문에 넘기거나 단순히 토큰 길이만 되돌리는 방식은 피했다.
또한 JSON 상태가 같아 보이는 것만으로 토큰 prefix까지 같다고 가정하지 않았다. 전체 입력의 토큰과 prefix 경계를 확인했다. 토큰화는 경계에 영향을 받을 수 있기 때문이다. 모델과 상태가 바뀌면 이전 항목을 재사용하지 않는다.
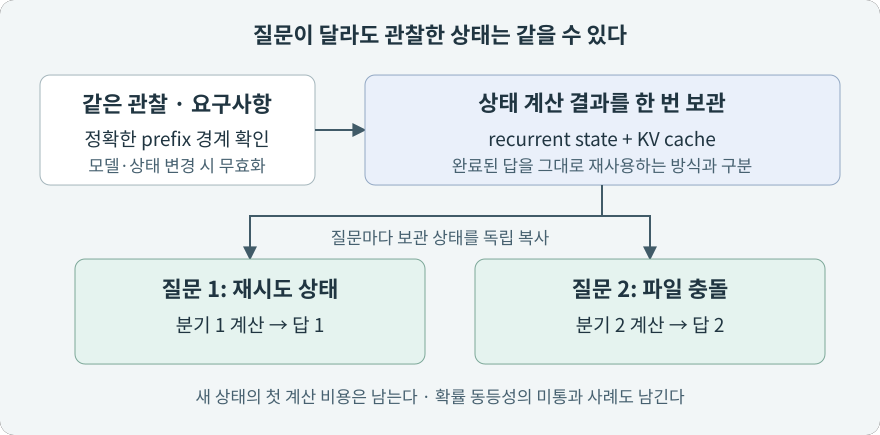
모델을 상주시킨 뒤 측정한 요청 시간은 다음과 같았다. 시간에는 토큰화, miss의 캐시 생성, 분기 복사와 해당 요청의 모든 질문이 포함된다.
| 업무에서 가져온 입력 | 질문 수 | 캐시 없는 요청 | cache miss | cache hit 중앙값 |
|---|---|---|---|---|
| 동시 진단의 간섭 여부 | 1 | 6.763초 | 6.814초 | 2.427초 |
| 재시도 상태와 파일 충돌 | 2 | 13.123초 | 8.878초 | 4.058초 |
| 권위 명단과 표시 불일치 | 1 | 4.676초 | 5.206초 | 2.079초 |
| 과거 기록을 인위적으로 반복한 입력 | 1 | 31.467초 | 31.975초 | 2.649초 |
같은 상태의 후속 질문에서는 기다리는 시간이 줄었다. 질문 두 개를 한 번에 묶은 입력은 처음 상태를 처리하는 miss에서도 공통 계산을 나누어 약 13.1초에서 8.9초로 줄었다.
반면 질문 하나의 새 상태에서는 캐시 생성이 공짜가 아니었다. miss가 캐시 없는 실행보다 비슷하거나 더 느렸다. “PPLX를 이제 2초에 쓴다”는 표현은 상태 재사용 조건을 빼면 부정확하다.
이 시험은 캐시 없는 실행을 먼저 하고 캐시 실행을 뒤에 했다. 실행 순서와 시스템 부하를 무작위로 바꾼 생산 벤치마크가 아니다. 업무 입력의 hit 중앙값도 세 가지 선택지 순서에서 나온 연관 관찰이고, 긴 반복 입력은 인위적인 스트레스 사례다.
선택지는 같았지만 확률 분포는 완전히 같지 않았다
36개의 캐시 질문 비교에서 선택된 답은 모두 같았다. 하지만 사전에 정한 후보 확률 차이 허용값 0.005를 넘은 비교가 두 개 있었다. 최대 차이는 0.009574, 약 0.9574퍼센트포인트였다.
작은 FP32 캐시 검증과 분기 독립성 확인은 통과했지만 전체 양자화 모델의 확률 동등성은 모든 비교에서 통과하지 못했다. 계산을 나누며 낮은 정밀도의 수치가 달라졌을 가능성은 있으나, 그 원인을 확인한 것은 아니다.
이 차이는 숨기기 쉬운 결과다. 최종 선택지만 보면 모두 통과했기 때문이다. 그러나 경계 부근에서 분포가 달라지면 다른 입력에서는 선택지가 바뀔 수 있다. 따라서 이 구현을 완전히 무손실이라고 쓰지 않았다.
보관한 prefix 배열은 약 171~271MB였다. 모델 가중치, 질문별 복사, 메모리 할당기와 운영체제 비용은 이 숫자 밖에 있다. 현재 구조는 prefix를 하나만 보관한다. 여러 작업이 번갈아 들어오면 적중이 줄 수 있지만 실제 생산 적중률은 아직 측정하지 못했다.
입력을 짧게 쓰는 방법은 별도 시험이었다
중요한 관찰과 관계를 남기고 상태를 수동으로 다시 썼을 때 일반 업무의 캐시 없는 지연 개선은 약 0.2~6.9%였다. 인위적 반복 입력에서는 1,907토큰을 409토큰으로 줄이며 31.467초가 6.752초가 됐다.
큰 차이는 주로 일부러 반복한 자료를 없앤 시험에서 나왔다. 이를 평소 업무에서 4배 이상 빨라진다고 설명할 수는 없다. 상태를 다시 작성한 시간과 실제 업무에서의 의미 보존 비용도 측정하지 않았다.
근거를 짧게 쓰는 것이 무조건 좋지도 않다. 중요한 조건 하나를 지우면 모델이 빠르게 잘못 판단한다. LAYA 비교에서 조건이 빠진 개발 사례를 제외했던 경험 때문에, 속도와 함께 정보가 보존됐는지를 확인했다.
14. 중복 토큰화는 없앴다. 큰 속도 개선은 아니었다
상주 서비스의 입력 흐름을 보니 제출 제한을 확인하기 위해 전체 질문을 토큰화한 뒤, 추론 함수에서 같은 질문을 다시 토큰화했다. 앞 단계에서 검증한 토큰 목록을 다음 단계에 넘기지 않아 생긴 중복이었다.
실제 개발 입력 여덟 종류를 CPU에서 반복 측정했다. 일반 입력의 추가 토큰화 중앙값은 0.255~0.668ms, 긴 반복 입력은 1.421ms였다. 첫 토크나이저 로딩 비용도 별도로 있었다.
수초의 모델 계산과 비교하면 아주 작은 비용이다. 그래도 같은 일을 두 번 할 이유는 없었다. 서비스의 입장 검증 단계에서 만든 질문 ID별 토큰 목록을 추론 함수에 전달하도록 수정했다. 독립적으로 추론 함수를 호출하는 경우에는 기존 토큰화 경로를 남겼다.
서비스 전체 질문 토큰 합계 제한도 유지했다. 4,096토큰은 허용하고 4,097토큰은 거부하는 경계 확인, 질문 ID 불일치 거부, 준비 단계 실패 시 추론 미실행을 시험했다. prefix 경계 확인에 필요한 토큰화까지 없앴다고 주장하지는 않았다.
수정 전후 HTTP 시험 두 건에서 선택, 토큰 길이, prefix 길이와 확률이 같았고 최대 확률 차이는 0.0이었다. 배포한 소스와 시험한 소스의 해시도 대조했다. 실제 초과 입력은 모델을 호출하지 않은 채 제한 오류를 반환했다.
이것은 우리 서비스 래퍼에서 만든 중복을 제거한 것이다. Hugging Face 원본의 버그를 찾았다는 주장은 아니다. 일반화할 수 있는 내용은 검증 과정에서 이미 만든 토큰을 추론까지 유지하자는 패턴이다. 전체 요청 시간이 얼마나 줄었는지를 통제해서 재측정하지는 않았으므로 이 수정에 별도의 큰 속도 향상 수치를 붙이지 않았다.
15. v12는 두 답을 병렬로 받는다
0.8B의 속도와 27B의 이 업무 묶음에서의 판단 품질을 함께 보고 싶어 v12에서는 두 모델을 동시에 호출하도록 했다. 판단 입력을 한 번 검증하고 명시적 제외를 적용한 뒤, 같은 패킷을 KEV와 PPLX에 보낸다.
기존 answers는 KEV의 답으로 유지했다. PPLX의 답은 comparison.answers에 들어간다. 질문별 불일치도 기록한다. 둘이 다르면 주 모델이 근거와 요구사항을 대조한다. 둘이 같아도 정답으로 확정하지 않는다.
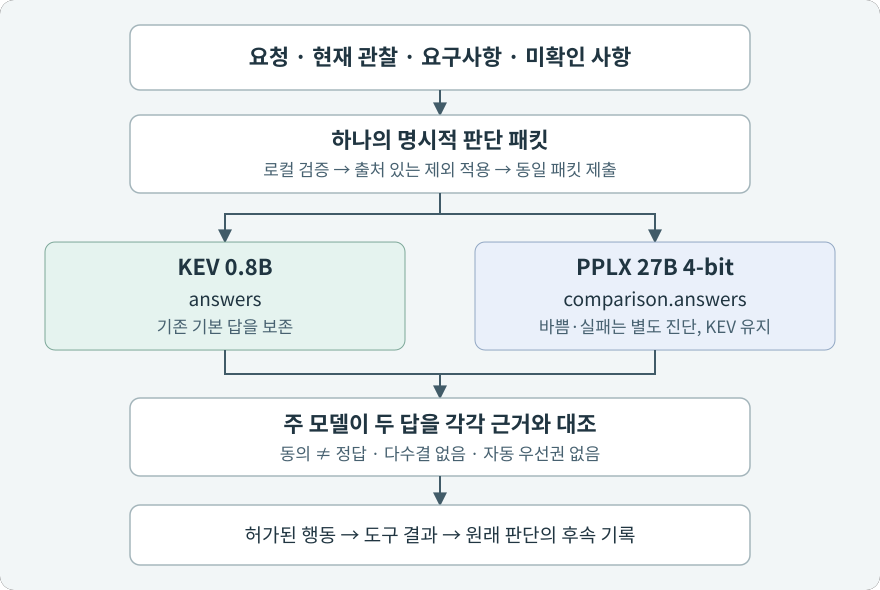
현재 병렬은 둘 중 빠른 답을 받아 즉시 반환하는 경주와 다르다. 두 답을 비교하기 위해 정상 경로에서는 더 오래 걸리는 쪽을 기다린다. 순차 호출보다 겹치는 시간을 줄일 수는 있어도 KEV 단독의 지연을 유지하는 구조는 아니다.
이 관계를 단순화하면 전체 지연은 패킷 준비와 검증, 두 모델 처리 시간 중 긴 쪽, 답 검수와 행동을 합친 것이다. 실제 구현에는 통신과 스케줄링도 들어간다. 판단 모델 두 개를 붙였다는 이유로 주 모델의 모든 추론 시간까지 그만큼 사라지는 것도 아니다.
짧은 HTTP 상태 질문으로 설치 후 확인한 첫 상태는 전체 2.829초였다. KEV는 0.435초였고 PPLX는 2.808초였다. 같은 상태를 다시 사용한 요청은 전체 1.141초, KEV 0.176초, PPLX 1.122초였다.
이 둘은 설치 확인 요청이다. 평소 업무 질문 전체의 중앙값이 아니다. 앞서 실제 업무에서 가져온 상태의 첫 질문은 5~7초 이상이었고 보관 상태의 후속 질문은 대략 2~2.4초였으며 여러 질문은 더 오래 걸릴 수 있었다.
바쁠 때는 어떻게 되는가
PPLX 서비스는 추론 worker 하나와 보관 prefix 하나를 사용한다. 이미 추론 중인데 새 요청이 겹치면 comparison_busy로 거부한다. 같은 상황에서도 KEV 답은 남긴다. 통제된 겹침 시험에서는 KEV 답이 0.155초에 도착했고 PPLX의 바쁨 진단이 함께 기록됐다.
자동 재시도는 넣지 않았다. PPLX 응답 제한은 75초이며, HTTP 대기가 끝났어도 실제 모델 계산이 계속되어 worker를 잡고 있을 수 있다. 전체 질문의 토큰 합계 제한은 이 부담을 줄이기 위한 보수적인 입장 제한이다. 모델의 이론적 최대 문맥 길이와 같은 개념은 아니다.
다섯 Codex 런타임과 여섯 Hermes 런타임에 v12 클라이언트와 지침을 적용하고 설치 확인을 수행했다. 이는 런타임 프로필 수이며 컴퓨터 열한 대라는 뜻이 아니다. 기존 GUI 세션이 모두 다시 설정을 읽었는지와 오래된 묶음형 대체 클라이언트까지 같은 경로를 쓰는지는 별도 확인이 남아 있다.
생명주기 훅은 여전히 모델을 호출하지 않는 체크포인트다. 실제 구체적 판단 패킷을 제출할 때 두 모델이 호출된다. 이 구분을 유지하지 않으면 도구를 사용할 때마다 27B를 두드리는 비용 큰 구조가 되거나, 체크포인트 수천 개를 실제 판단 상담 수처럼 보고하게 된다.
16. 실제 모니터링은 무엇을 말해 주었나
v12 이전의 마지막 일일 관찰 창에서 실제 상담 기록은 79건, 질문은 98개, 기권은 38개였다. 질문을 분모로 한 기권 비율은 38.8%다. 설치·시뮬레이션 출처의 텔레메트리 행 240개는 별도로 제외했다. 제외 행 수가 상담 240건이라는 뜻은 아니다.
이 창은 v11 클라이언트 사용 기록이다. v12의 병렬 비교 효과를 측정한 결과로 제시할 수는 없다. 실험 관리와 모니터링 작업의 호출도 실제 상담 기록에 섞일 수 있다.
그전 창에서는 질문 60개 중 기권 11개, 18.3%였다. 초기 설치 중심 관찰의 92.7%, 그 뒤의 여러 30~40%대 수치를 한 그래프로 이어 “정확도가 계속 좋아졌다”고 말하고 싶을 수 있다. 하지만 질문 내용, 분모, 창 길이, 버전과 업무 구성이 바뀌었다. 기권이 줄어든 것이 틀린 구체적 선택이 늘어난 결과일 수도 있다.
마지막 창에는 기록된 판단 실패나 후속 기록 실패가 없었다. 후속 기록은 79건 중 73건에 연결됐다. 실제 행동 참조가 있는 것은 64건, 요구사항 참조가 있는 것은 54건이었다. 추가 도구 호출 수와 재작업 수는 각각 일곱 건에만 있었다.
| 마지막 v11 관찰 창의 항목 | 수치 | 읽을 수 있는 범위 |
|---|---|---|
| 상담 / 질문 | 79건 / 98개 | 로그에 있는 실제 상담과 질문 |
| 질문 기권 | 38/98, 38.8% | 답이 기권인 비율 |
| 후속 기록 연결 | 73/79 | 후속 기록이 존재하는 비율 |
| 행동 참조 | 64/79 | 실행 결과를 가리키는 참조가 있는 비율 |
| 요구사항 참조 | 54/79 | 요구사항 참조가 있는 비율 |
| 도구 수·재작업 수 기록 | 각각 7/79 | 비용 비교에 쓸 관찰 범위가 매우 작음 |
활성 상담이 나온 런타임별 요청 지연 중앙값은 140.6~258.0ms, p95는 301.9~409.8ms였다. 서로 다른 업무가 섞인 런타임 지표여서 이 범위로 하나의 통합 p95를 만들지는 않았다. 체크포인트의 짧은 실행 시간은 상담 지연에 넣지 않았다.
보이는 실제 완료 작업도 최대 다섯 개까지 골라 정상 영수증과 결과를 확인했다. 두 대상만 옮긴 작업에서 제한된 범위가 유지됐는지, 기존 워크플로를 재사용했는지, 사용량 관찰만으로 스킬 변경을 만들지 않았는지처럼 구체적으로 살폈다.
일부 선택과 실제 결과가 맞물렸다는 근거는 있었다. 하지만 정상 영수증을 확인한 것과 원격 데이터 전체를 독립적으로 다시 감사한 것은 다르다. 다른 선택을 했다면 더 나빴을지도 측정하지 않았다. 성공한 작업이 모든 기권을 오답으로 바꾸지는 않는다.
무엇보다 비교 가능한 작업 시간·토큰 기준선이 없었다. 따라서 “빠르게 호출된다”는 것은 확인했지만 “전체 업무 시간을 줄였다”, “토큰 비용을 절감했다”는 효과는 아직 증명하지 못했다. 초기 기존 스킬 비교 한 번을 서로 다른 모든 후속 업무의 기준선으로 쓸 수도 없다.
17. 이번 실험에서 판단을 맡기는 기준이 바뀌었다
처음에는 판단 모델의 응답 속도가 빠르면 주 모델도 빨라질 것이라고 생각하기 쉬웠다. 실제로는 질문을 만드는 방식, 답을 읽는 방식, 틀렸을 때 처리하는 방식이 상당한 비중을 차지했다.
현재 구조에서 유지하는 기준은 다음과 같다.
관찰된 사실에서 출발한다. 요청의 정확한 조건, 현재 도구 결과, 알려진 미확인 사항을 넣는다. 결론을 먼저 정하고 동의를 요청하지 않는다. 과거 상태와 현재 상태, 프로세스 실행과 실제 기능 확인을 구분한다.
한 질문은 하나의 판단을 맡는다. 재시도가 존재하는지와 파일 충돌을 고칠지는 분리할 수 있다. 같은 근거를 공유하는 독립 질문은 묶되, 앞 판단의 결과가 필요한 다음 질문을 미리 독립인 것처럼 처리하지 않는다.
실제 행동을 선택지에 쓴다. ID나 호의적인 형용사에 의미를 숨기지 않는다. 명시적으로 금지된 행동은 출처 있는 제외로 처리한다. 불확실성은 남긴다.
답을 근거와 다시 대조한다. 선택지 순서를 바꾸어 답이 달라진 실제 사례가 있었다. 평소 업무에서 순서를 계속 바꾸어 다수결하지는 않는다. 기권 뒤 재상담도 실제로 새로운 근거가 생겼거나 질문 범위를 바로잡은 경우에만 제한적으로 한다. 좁힌 새 질문의 성공을 원래 질문의 개선으로 채점하지 않는다.
실행 권한과 판단을 분리한다. 판단 모델의 선택은 삭제, 결제, 보안 또는 권한 변경의 새로운 승인이 아니다. 기존 사용자 지시와 런타임 제한을 따라야 한다. 빠른 보조 모델이 권한을 넓히지 않는다.
행동 후에는 원래 판단으로 돌아간다. 채택·거부·보류와 실제 도구 결과를 연결하되, 확인하지 못한 것은 모른다고 기록한다. 잘된 결과와 올바른 판단은 따로 평가한다. 두 모델을 비교할 때도 KEV와 PPLX의 검증 라벨을 각각 남긴다.
이렇게 적으면 당연한 규칙처럼 보인다. 실제 연동에서는 이 당연한 규칙이 빠진 곳마다 수치가 왜곡되거나 원인을 못 찾는 실패가 생겼다.
18. 확인한 것과 아직 확인하지 못한 것
작은 모델은 분명 빨랐다. 당시 KEV 0.8B는 많은 구체적 판단에서 수백 ms 안에 응답했다. LAYA도 시험한 직접 실행 경로에서 매우 빨랐다. 다만 빠르다는 이유만으로 업무 조건을 잘 지킨 것은 아니었다.
PPLX 27B 4-bit는 이 업무 기반 비교에서 KEV보다 참조 일치와 선택지 순서 안정성이 좋았다. 그러나 쉬운 개발 묶음의 48/48 뒤에는 원본 요청의 기권과 스트레스 묶음의 불일치가 있었다. “사실상 100%”라는 표현을 유지할 수 있는 범위는 그 특정 개발 묶음뿐이다.
공통 상태 캐시는 조건이 맞을 때 도움이 됐다. 같은 상태의 다른 질문에서도 사용할 수 있고, 여러 질문을 묶으면 첫 요청에서 공통 계산을 나눌 수 있었다. 반면 새 상태, 캐시 경쟁, 긴 입력, 확률의 작은 차이는 남아 있다.
중복 토큰화 제거는 제대로 확인한 작은 수정이다. 의미 있는 기술적 정리는 맞지만 초 단위 추론 시간을 바꾸는 성과처럼 포장할 정도는 아니었다. 컴파일 시험도 결과를 그대로 남겼다. 빨라지지 않은 최적화 시험이 다음 선택을 좁히는 데는 도움이 됐다.
다음 효과 검증에는 새 버전을 하나 더 만드는 것보다 비교 가능한 업무 묶음이 필요하다. 향후 확인할 항목은 세 가지다.
첫째, 원본 패킷과 요구사항을 먼저 고정하고 가능하면 독립 평가자가 참조와 미채점 조건을 정한 업무 표본이 필요하다. 개발 사례, 실패를 골라 만든 사례, 실제 일반 업무를 따로 집계해야 한다. 기권율뿐 아니라 잘못된 구체적 선택과 유용한 판단 범위를 함께 봐야 한다.
둘째, 전체 작업을 시작부터 결과 확인까지 한 번 측정해야 한다. 준비 시간, 판단 호출, 주 모델의 검수, 추가 도구 호출과 재작업을 포함하고 같은 종류의 기준선 업무와 비교해야 한다. 응답 시간을 더하거나 캐시 적중 속도를 곱해 전체 절감을 추정해서는 안 된다.
셋째, 실제로 같은 상태가 얼마나 재사용되는지와 여러 작업이 겹칠 때 PPLX가 얼마나 바쁜지를 측정해야 한다. prefix 하나와 worker 하나라는 현재 조건에서의 적중률, 거부율, 새 상태·적중 상태별 p50/p95, KEV 단독으로 진행한 경우의 결과가 필요하다. 이 측정을 아직 완료한 것처럼 쓸 수는 없다.
지금 선택한 v12는 정답을 자동으로 결정하는 심판이 아니다. 빠른 작은 모델과 더 무거운 비교 모델의 답을 같은 입력에서 관찰하고, 주 모델이 근거를 확인하는 실험 구성이다. 그 구성이 업무 전체를 더 빠르고 싸게 만드는지는 남은 검증이다.
그래도 처음의 질문에는 더 구체적으로 답할 수 있게 됐다. 빠른 판단 모델을 붙이는 일은 가능하다. 실제로 도움이 되는 형태로 쓰려면 모델보다 먼저 판단할 문제를 제대로 만들어야 하고, 답을 실행과 결과에 연결해야 한다. 이 과정에서 얻은 실패 기록과 조건별 측정이, 가장 좋은 숫자 하나보다 다음 구현을 고르는 데 유용했다.
부록 A. 시험 구성을 다시 읽기 위한 표
아래 표는 이 글의 실험을 재해석할 때 필요한 조건이다. 같은 제품 이름으로 새 버전을 설치했을 때 동일한 결과를 기대하기 위한 표는 아니다.
| 후보 | 당시 사용한 구성 | 해석 시 주의할 조건 |
|---|---|---|
| KEV 0.8B | jaredpalmer/kev-0.8b, 고정 revision, 기존 로컬 서비스 | 새 입력·반복 입력, HTTP 및 클라이언트 시간 경계가 다름 |
| KEV 4B | 당시 kev-4b, MLX BF16, 별도 32GB Mac 시험 포함 | 더 작은 Mac의 시간 초과와 성공 실행을 섞지 않음 |
| KEV 8B | 과거 kev-8b, Torch 2.8.0 / Transformers 5.17.0, MPS BF16 | 현재 목록의 다른 크기 모델과 구분, 0.8B와 같은 백엔드가 아님 |
| JEV | 고정 jev-1.13.0, 호스팅 API | 여섯 요청의 클라이언트+통신 시간, 서버 내부 상태·청구 미확인 |
| LAYA | laya 0.3.21, laya-multilingual, MPS 직접 실행 | 작성한 개발 사례, 다른 변형·학습·보정 미시험 |
| PPLX | pplx-decider-v1-27b, MLX affine 4-bit group 64, BF16 readout 보존 | M4 32GB, 텍스트만, 전체 BF16 및 이미지 경로 미비교 |
PPLX 이식에는 MLX 0.32.2와 MLX-LM 0.31.3을 사용했다. API 세부 사항은 설치한 소스와 문서를 대조했다. 모델 파일과 입력의 고정성 확인은 했지만, 모든 실험이 같은 하드웨어·같은 백엔드·같은 타이밍 경계로 이루어진 통합 모델 벤치마크는 아니다.
중요한 체크포인트 식별자는 다음과 같다.
KEV 0.8B: 9a45d25eb2ab761841196625383fa1dff0e56c1e
과거 KEV 8B: c80773da7f383f93c4dbff0c0b008e0463f9145a
LAYA multilingual: e4e9ddf21a7b1903b7acffd8814ad4307bf63a67
PPLX Decider: 5117a6c7fe73b19308dc1a6b0fb529a40c2ecad4
위 구성 표와 고정 입력 방식은 실험 조건을 설명하지만, 이 글 자체가 공개 재현 패키지인 것은 아니다.
부록 B. 판단 패킷에서 보존하려 한 정보
실제 클라이언트는 더 많은 검증을 수행하지만, 선택형 패킷의 핵심 모양은 다음과 같다. 아래는 구조를 설명하기 위해 만든 예시이며 채점한 실험 사례가 아니다.
{
  "state": {
    "observations": [
      "재시도 작업이 활성 상태이며 다음 실행이 예약되어 있다.",
      "내보내기 대상은 디렉터리여야 하지만 같은 위치에 일반 파일이 있다."
    ],
    "requirements": ["기존 예약 작업은 보존한다."],
    "unknowns": ["충돌 해소 후 실제 내보내기 성공 여부는 아직 확인하지 않았다."]
  },
  "questions": {
    "first_inspection": {
      "type": "choice",
      "instructions": "내보내기 실패를 해결하기 위해 우선 확인할 것은 무엇인가?",
      "criteria": {
        "path_collision": "내보내기 대상의 파일·디렉터리 충돌을 확인한다.",
        "retry_absence": "재시도 예약이 없는지 확인한다.",
        "insufficient_evidence": "제공한 관찰로 두 확인 항목을 구분할 수 없다."
      }
    }
  }
}
스키마 검증은 이 JSON의 모양과 허용 필드를 확인한다. 사실이 충분한지, 선택지가 중립적인지, 해당 행동을 실행할 권한이 있는지까지 자동으로 해결하지는 않는다. 원본 근거와 연결하고 답을 검수하는 과정이 계속 필요하다.
부록 C. 숫자를 볼 때 구분한 단위
- 요청: API 또는 실행 함수에 패킷 하나를 제출한 것. 질문 여러 개를 포함할 수 있다.
- 질문: 하나의 판단 항목. 선택지 순서를 바꾸면 같은 질문의 반복 관찰이 된다.
- 참조 일치: 사전에 정한 요구사항·관찰 기반 답과 같음. 독립적인 생산 정답 라벨과 같지 않다.
- 잘못된 구체적 선택: 참조와 다른 행동을 선택함. 기권이나 실행 오류와 구분한다.
- 기권:
insufficient_evidence를 반환함. 적절한 기권인지 별도로 검토한다. - 체크포인트: 상담을 상기시키는 훅 실행. 모델 질문이나 기권으로 세지 않는다.
- 후속 기록: 원래 판단에 연결한 행동·검증 결과. 존재한다고 독립 검증된 것은 아니다.
- 판단 지연: 정한 구간의 호출 시간. 전체 업무 시간이나 준비 비용과 구분한다.
- GB / GiB: 각각 10억 바이트 / 2³⁰바이트. 파일 크기, MLX 할당, RSS, 시스템 메모리는 별도 항목이다.
참고 자료
- KEV 모델과 코드
- TypeSafe 문서
- TypeSafe 판단 워크플로 스킬
- omo-jev-plugin
- Unsloth Decision LAYA 문서
- PPLX Decider v1 27B 모델 카드
- 시험 revision의 PPLX 구현
- 시험 revision의 PPLX 학습 설정
- vLLM Automatic Prefix Caching
본문 표의 수치는 이 글에 설명한 로컬 실험과 운영 관찰에서 나온 값이다. 위 프로젝트의 공식 벤치마크 수치와 혼합하지 않았다.